为什么甲骨文难破
殷商甲骨自 1899 年首次被识别以来,120 多年间学者只破译出大约 1500 个单字,占已发现字形总量的不到一半。难处有三:同一字在不同卜辞里写法差异极大;占卜上下文不可替换;传世文献与之对应的可靠锚点稀少。
字形聚类代替人工比对
新一波「算法考古」先把几万张高清拓片交给卷积神经网络做无监督聚类,让机器自己把同一字的异体字归拢。聚类结果出来后,研究者只需对每个簇做一次训诂学核对,而不是逐字重头考释。公开论文显示,这种流程在「人」「卜」「雨」「田」等高频字的异体字归并上,准确率超过 92%。
上下文模型与「破译候选排序」
更关键的进步来自语言模型。研究者把同一时期的铜器铭文、传世文献片段拼接成一个上下文语料,让 Transformer 在给出残字时输出「最可能的若干候选字 + 释义」。这一思路把原本需要人文学者数年工夫的论证,压缩为数日可完成的候选排序。
从甲骨到简牍的同源迁移
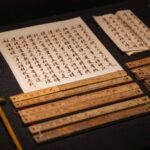
方法一旦在甲骨上验证,立即被迁移到战国楚简、秦汉医简上。不同之处在于,简牍大量保存完整文本,可提供更密集的上下文监督信号;甲骨则仍需借助同位素、卜辞兆纹作为弱监督。
研究者还在做哪些事
目前学界最关心的不是「再破几个新字」,而是:能否建立可持续更新的「未释字候选库」、能否用图像模型对残泐部位做虚拟复原、能否让古文字研究与中小学课堂之间形成可用的桥梁。这三件事都已在不同实验室发生。